
Les agents IA capables d’interagir avec un ordinateur via des interfaces graphiques (cliquer, naviguer, remplir des formulaires etc) se multiplient rapidement. Claude Computer Use, OpenAI Operator, Project Mariner (Google Deepmind), Runner H (H Company) : les géants de la tech, les providers IA et les plus petits acteurs, comme la startup française H, développent leurs computer use agents (CUA). Ces agents se distinguent des assistants IA classiques : ils n’assistent plus, ils agissent. Plutôt que de suggérer une réponse, ils exécutent des actions sur de vrais systèmes. Comment l’utilisateur garde-t-il le contrôle sur ce que l’agent fait ? Comment sait-il ce dont l’agent est capable ? À quel moment l’utilisateur doit intervenir ? Ces questions, que les assistants IA conversationnels n’avaient pas à traiter, restent sans réponses.
Ce sont ces questions que pose une récente étude d’Apple Machine Learning Research, “Mapping the Design Space of User Experience for Computer Use Agents” (Cheng et al., 2026), sur l’expérience utilisateur (UX) des computer use agents. En combinant une analyse des systèmes existants, des entretiens experts et une étude empirique conduite avec de vrais utilisateurs, les chercheurs dressent une taxonomie des besoins UX des personnes qui interagissent avec ces agents.
Des scripts aux agents LLM : une évolution rapide des CUA
Les computer use agents ne sont pas nés avec les LLM. Les premiers systèmes, comme CoScripter développé par IBM dans les années 2000, permettaient déjà d’enregistrer et rejouer des séquences d’actions sur un navigateur web. C’était une sorte de macro intelligente, mais incapable de s’adapter à des contextes changeants, du fait des limitations des technologies de l’époque.
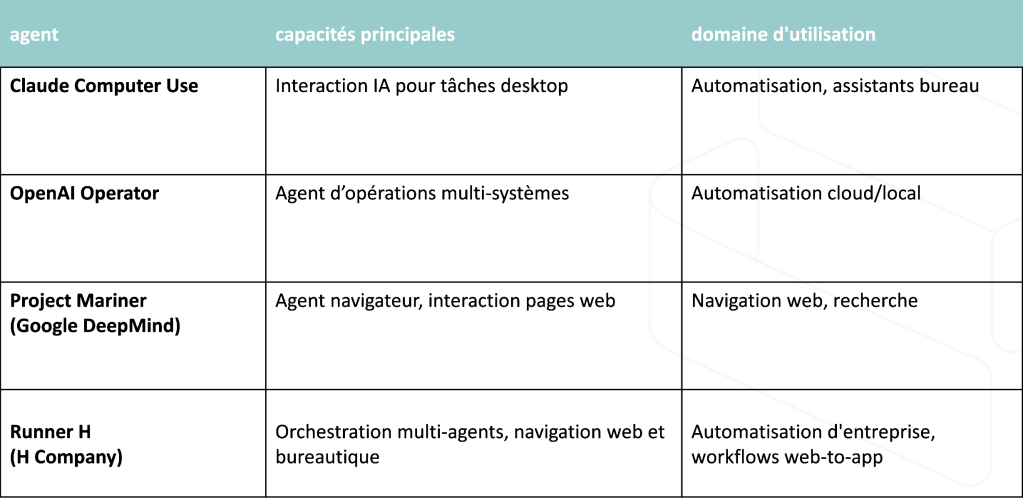
L’arrivée des LLM a transformé le développement de ces agents. Là où CoScripter nécessitait des scripts explicites, des agents comme OpenWebAgent ou Claude Computer Use comprennent des instructions en langage naturel et s’adaptent dynamiquement à l’interface qu’ils observent. Le tableau ci-dessous illustre la diversité des solutions aujourd’hui disponibles :
Le domaine évolue donc rapidement. Mais alors que le domaine de l’UX classique a mis des décennies à construire ses méthodologies et représente aujourd’hui un marché de 8,5 milliards de dollars en 2022, projeté à 25,4 milliards d’ici 2030 (source: Gitnux – UX industry statistics), l’étude de l’UX des agents autonomes repart presque de zéro, car les mécanismes d’interactions humain-agent IA-machine sont encore trop récents.
Comme une mauvaise UX cause en moyenne une perte de 52% des utilisateurs (encore d’après Gitnux – UX industry statistics), le développement des CUA doit se baser sur les attentes et les besoins de ces utilisateurs humains.
Cartographier l’UX en trois étapes
Pour comprendre les attentes et les besoins des utilisateurs face aux CUA, les chercheurs d’Apple ont adopté une démarche en trois phases complémentaires.
La première consiste en une analyse des systèmes existants : en étudiant les interfaces et documentations des principaux agents CUA du marché, ils dressent une première taxonomie des dimensions UX mobilisées ou négligées par ces systèmes.
La deuxième phase consolide cette taxonomie par des entretiens d’experts du domaine agentique, pour valider et affiner les catégories identifiées.
La troisième est une Wizard of Oz study, plus connu en France sous le nom de Turc mécanique: un type d’étude éprouvée en recherche UX où un humain simule le comportement d’un système automatisé à l’insu des participants. Des utilisateurs réels interagissent avec ce qu’ils croient être un vrai agent CUA, tandis que les chercheurs observent leurs attentes, leurs frustrations et leurs stratégies d’adaptation. Cette approche permet d’évaluer les besoins utilisateurs sans être contraint par les limitations techniques des systèmes actuels.
Quatre dimensions clés pour définir l’UX des computer use agents
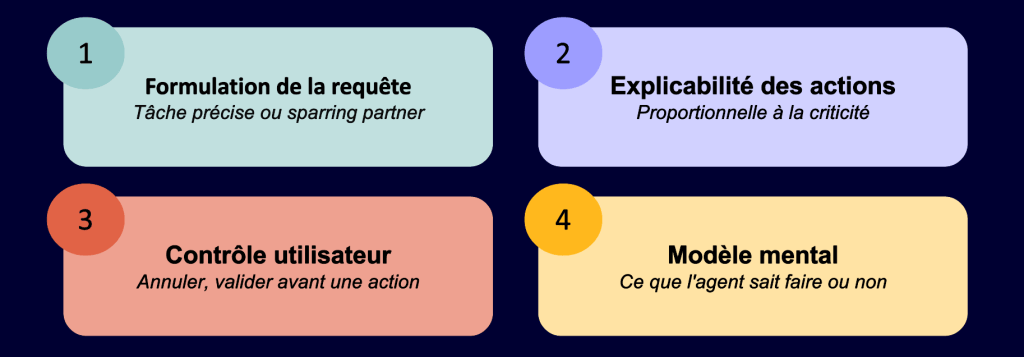
L’étude fait émerger quatre grandes dimensions de l’UX des computer use agents.
1. La formulation de la requête (User Query)
La façon dont un utilisateur exprime sa demande à un agent dépend de ce qu’il cherche à accomplir et de sa propre clarté sur l’objectif. Certains utilisateurs arrivent avec une tâche précise et délimitée : l’agent doit exécuter, sans itération superflue. D’autres, en revanche, souhaitent un véritable sparring partner : ils explorent et co-construisent le résultat avec l’agent.
Un agent extracteur d’information dans un document n’a pas besoin du même mode d’interaction qu’un agent assistant à la rédaction d’un rapport stratégique, où c’est l’itération et le dialogue qui vont permettre de produire un résultat satisfaisant.
2. L’explicabilité des actions (Explainability)
La criticité de la tâche détermine ce qui doit être montré et expliqué par l’agent. Pour une action à faible enjeu, une surveillance pas à pas est une friction inutile qui annule le bénéfice de l’automatisation. Par contre, pour une action sensible, comme envoyer un email au nom de l’utilisateur ou modifier un fichier partagé, l’absence d’explication devient un frein et même un risque à l’adoption.
3. Le contrôle utilisateur (User Control)
C’est la dimension la moins bien adressée par les systèmes actuels, et pourtant l’une des plus déterminantes pour la confiance. Les utilisateurs expriment deux besoins distincts : pouvoir revenir en arrière sur une action déjà exécutée, et pouvoir valider avant une action potentiellement risquée.
En ce qui concerne la validation, on peut intégrer un agent évaluateur, distinct de l’agent principal, chargé de détecter les actions à risque et d’alerter l’utilisateur avant leur exécution. Ce pattern d’architecture multi-agents permet de séparer la logique d’exécution de la logique de supervision.
4. Le modèle mental et les attentes (User Mental Model)
Cette dimension concerne la compréhension par l’utilisateur de ce que l’agent sait et ne sait pas faire. Un utilisateur familier du périmètre d’action de l’agent sera naturellement plus enclin à déléguer sur des tâches où l’agent a un taux de succès plus élevé. La satisfaction de l’utilisateur est directement impactée.
Mais comme le montre le papier Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs (Mia Xiong et al., 2024), les LLM peinent à reconnaître les limites de leurs connaissances et à dire “je ne sais pas” de façon fiable. Sur des tâches bien délimitées, des règles déterministes peuvent compenser cette lacune en bornant explicitement le périmètre de l’agent. Mais le problème reste entier sur des tâches plus ouvertes.
Ce que les utilisateurs montrent en pratique
Les résultats de la Wizard of Oz study confirment et nuancent ces dimensions. On note les points suivants :
- Le niveau d’explicabilité attendu dépend de la criticité de la tâche. Les utilisateurs ne veulent pas tout voir, ils veulent voir ce qui compte. Un agent qui reporte chaque micro-action est perçu comme bruyant et peu efficace. La transparence doit être proportionnelle à l’enjeu de l’action.
- La confiance se construit par l’interface autant que par les capacités. Un utilisateur qui reconnaît l’interface dans laquelle l’agent opère est significativement plus à l’aise pour déléguer des tâches.
- Le rôle de l’utilisateur est dynamique. Au fil d’une session, l’utilisateur alterne entre plusieurs postures : acteur qui guide, revieweur qui valide, observateur qui surveille. Un système qui ne facilite pas ces transitions de rôle crée de la friction inutile. Dans de nombreux scénarios l’agent est perçu comme un sparring-partner.
Les utilisateurs non-experts restent le vrai défi
Les auteurs sont explicites sur les limites de leurs résultats. L’étude a été conduite avec des participants familiers des LLM et des outils IA, qui ne représentent pas la majorité des utilisateurs potentiels en entreprise. Pour des populations moins technophiles, les besoins en explicabilité, en contrôle et en construction du modèle mental pourraient être plus importants et plus difficiles à satisfaire.
C’est là que réside l’enjeu pour les équipes qui déploient ces agents dans des contextes métier réels. Pour les utilisateurs experts, un raccourci de langage, une action implicite, une étape non expliquée par le CUA peut être compensée par leur connaissance du système. Ce que les utilisateurs non techniques ne peuvent pas faire. C’est là que réside la difficulté de l’UX des computer use agents.
Ce que cela change pour la conception de systèmes agentiques
Cette taxonomie offre une grille de lecture actionnable pour les équipes qui conçoivent ou déploient des agents en production.
Avant de choisir un niveau d’explicabilité ou un mode d’interaction, il faut se demander s’il s’agit-il d’une automatisation répétitive et délimitée, ou d’une collaboration exploratoire ? La réponse détermine les choix d’interface.
Enfin, la capacité d’un agent à exprimer ses propres limites est un prérequis à la confiance. C’est un problème ouvert, mais des approches existent : architectures multi-agents avec des agents évaluateurs dédiés, guardrails déterministes qui bornent le périmètre d’action, control checks avant les actions à risque. Des mécanismes complémentaires pour construire des systèmes agentiques satisfaisant les attentes des utilisateurs.


