
En production, le dimensionnement GPU est une question fondamentale. Il s’agit d’un choix d’architecture et d’infrastructure qui impacte directement la latence, la disponibilité, les SLA (Service Level Agreement) et le coût opérationnel.
On doit aussi dimensionner d’autres composants, comme le CPU pour l’orchestration, mais ce n’est pas l’objet de cet article.
Pour des chatbots LLM en production, le dimensionnement GPU est influencé par plusieurs choses comme la taille du modèle, le nombre de requêtes concurrentes, le time to first token, la taille des contextes et les objectifs de latence.
Avec un mauvais dimensionnement, l’infrastructure atteint rapidement ses limites : les requêtes sont ralenties ou limitées (throttling) afin d’éviter la saturation GPU, entraînant une dégradation de la latence et des timeouts.
Le dimensionnement doit régulièrement être adapté aux contraintes changeantes de l’application, ce qui implique de mesurer certaines métriques en production comme l’empreinte mémoire, le throughput par GPU et la latence.
Cet article propose une lecture infra-first, inspirée des pratiques MLOps observées en production et des outils fournis par NVIDIA.
Quand le dimensionnement GPU devient un enjeu critique
Tant que l’on reste dans un notebook ou en POC, le GPU est perçu comme une ressource interchangeable: on teste des modèles, on ajuste les batchs et les contextes, et les erreurs ne coûtent que du temps de développeur (voir Figure 1).
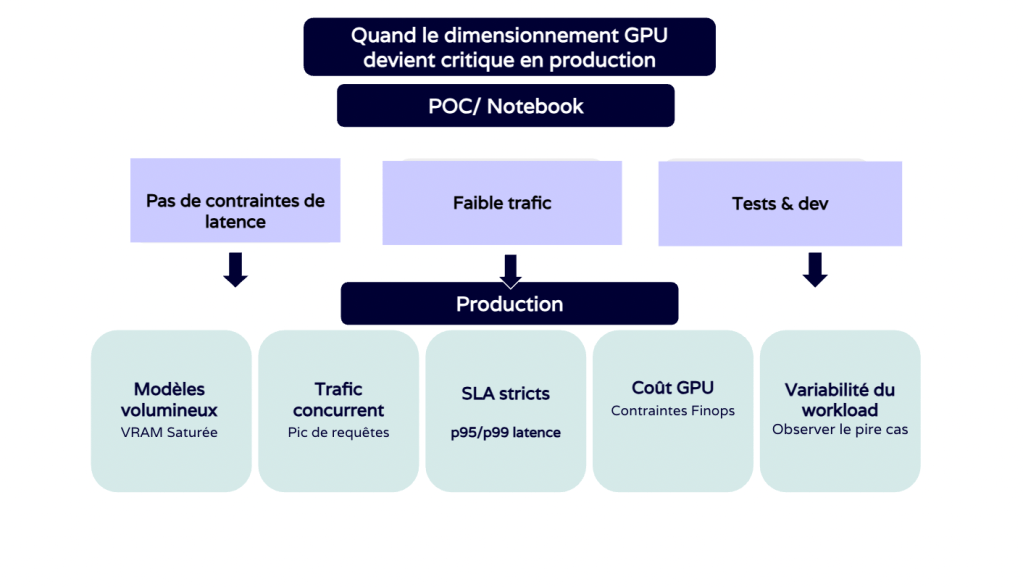
Figure 1: Illustration de la nécessité de dimensionnement GPU
En production, la situation change radicalement. Le GPU devient une brique critique de la plateforme, au même titre que le réseau, le stockage ou la base de données. Plusieurs facteurs expliquent cette bascule :
- Modèles volumineux (LLM ≥ 7B ou vision haute résolution) qui consomment beaucoup de VRAM et saturent rapidement les ressources de calcul.
- Trafic concurrent et imprévisible, où le nombre de requêtes simultanées peut dépasser la capacité d’un GPU unique.
- SLA de latence stricts, où chaque milliseconde compte pour l’expérience utilisateur. Une latence maximale absolue étant difficile à garantir dans des environnements fortement variables, les percentiles p95 et p99 permettent de mesurer une latence représentative de l’expérience utilisateur réelle, tout en excluant les cas extrêmes.
- Contraintes FinOps, avec un coût GPU qui peut rapidement devenir dominant si l’infrastructure est surdimensionnée ou mal dimensionnée.
Le dimensionnement GPU conditionne alors directement la qualité de service perçue et la viabilité économique de l’application.
📘 Ressource NVIDIA
AI Virtual Workstation Sizing Guide
https://docs.nvidia.com/vgpu/toolkits/ai-vws/latest/sizing.html
Comprendre la charge réelle, pas celle imaginée
Si le dimensionnement doit initialement se faire sur la base d’hypothèses a priori, une fois que l’application est en production, il est impératif de mesurer certaines métriques comme l’usage VRAM, GPU, ou la latence, pour adapter le dimensionnement aux besoins qui évoluent dans le temps. Deux workloads apparemment similaires peuvent avoir des comportements radicalement différents : chaque modèle a un profil d’exécution unique, qui dépend autant de son architecture que de la manière dont il est utilisé.
En inférence, la contrainte principale est souvent la mémoire GPU (VRAM), bien plus que la puissance de calcul brute. Plusieurs facteurs influencent fortement la consommation et la performance :
- Taille et architecture du modèle : les paramètres du modèle doivent être chargés en mémoire pour réaliser les opérations matricielles que réalise le LLM pendant son inférence. Cependant, le nombre de ces paramètres n’est pas le seul facteur nécessitant de la mémoire.
- Précision numérique : si les paramètres du modèle sont des nombres flottants (par exemple float32), il est possible de les stocker sous un format plus léger via la technique de quantization, ce qui réduit le besoin en VRAM.
- Longueur du contexte: séquences d’entrée et de sortie plus longues augmentent la pression mémoire (activations, KV cache) voir ce document.
- Batching et parallélisme: le regroupement des requêtes impacte à la fois le throughput (nombre de tokens par seconde) et l’utilisation GPU.
Exemple concret : deux modèles de 7 milliards de paramètres peuvent avoir des empreintes mémoire très différentes, selon qu’ils utilisent du FP16 avec batching optimisé ou du FP32 en traitement séquentiel. Sans mesure, il est impossible de savoir lequel tiendra réellement sur un GPU donné.
👉 C’est pourquoi le profilage est indispensable dès que les usages réels deviennent mesurables. Un récapitulatif est présenté à la Figure 2.
Un profilage sérieux doit inclure :
- Latence p50 / p95 / p99,
- Throughput effectif (tokens/s, requêtes/s),
- Empreinte mémoire GPU réelle,
- Ratio compute-bound vs memory-bound,
- Temps passé en file d’attente.
Des outils comme NVIDIA Model Analyzer permettent d’automatiser ces mesures, de comparer différentes configurations (précision, batch size, parallélisme) et d’identifier les véritables goulets d’étranglement avant la mise en production.
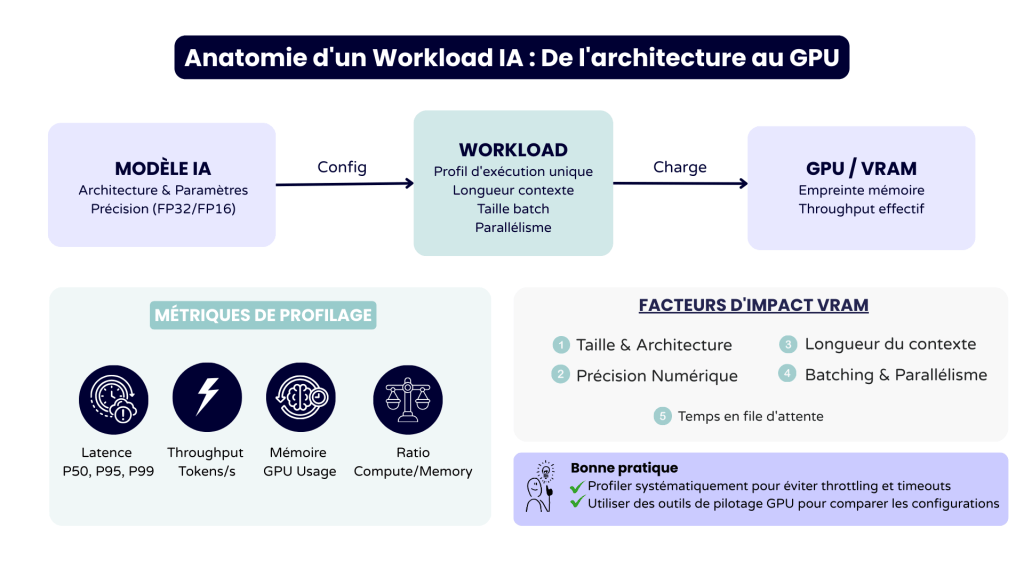
Figure 2: Schéma récapitulatif
📘 Ressources NVIDIA
- GPU Memory Essentials for AI Performance https://developer.nvidia.com/blog/gpu-memory-essentials-for-ai-performance
- Maximizing Inference Performance with NVIDIA Model Analyzer https://developer.nvidia.com/blog/maximizing-deep-learning-inference-performance-with-nvidia-model-analyzer
Combien de GPU ? Du profilage au capacity planning
Le profilage réel du modèle est la base de toute planification GPU. Une fois les métriques clés connues (latence p95/p99, throughput effectif, utilisation VRAM), il devient possible de quantifier la capacité réellement requise de l’infrastructure :
- estimer le nombre de requêtes simultanées soutenables par GPU,
- définir la marge nécessaire pour absorber les pics de charge,
- calculer le nombre total de GPU requis pour garantir une latence minimale ou respecter les SLA.
Ces mesures sont nécessaires au dimensionnement optimal de l’application, mais il faut également prendre en compte la variabilité des requêtes (incluant la longueur des contextes) et l’orchestration (par exemple, batching).
📘 Ressources NVIDIA
- NeMo Agent Toolkit Sizing Calculator https://docs.nvidia.com/nemo/agent-toolkit/latest/workflows/sizing-calc.html
- AI Virtual Workstation Sizing Advisor https://docs.nvidia.com/vgpu/toolkits/ai-vws/latest/sizing.html
Choisir le bon type de GPU
Une fois la capacité globale estimée, une seconde décision structurante s’impose : le choix du type de GPU. Il n’existe pas de GPU universel ; le bon choix dépend des contraintes d’inférence observées lors du profilage.
- Workloads légers ou RAG → des GPU coût-efficaces (ex. L4, A10) sont souvent suffisants.
- Modèles volumineux ou multimodaux → davantage de VRAM et de bande passante mémoire (ex. L40S).
- Très gros modèles ou forte concurrence → architectures multi-GPU, avec une attention particulière à la communication inter-GPU.
Le point clé : le GPU doit être sélectionné à partir des métriques réelles (VRAM, latence, throughput), et non sur la base de la fiche produit ou d’hypothèses théoriques.
Ce qu’il faut retenir
En production, le dimensionnement GPU est un enjeu critique pour garantir un service efficace. Il requiert des estimations précises et dès que possible basées sur des mesures réelles.
- Le dimensionnement doit être piloté par des mesures réelles, pas des hypothèses.
- Pour choisir un GPU optimal, il est impératif de réaliser un profilage (mesures réelles) puis le capacity planning (capacités GPU requises)
- Des mesures fréquentes ou automatisées sont essentielles afin de garantir un comportement optimal et de garder le contrôle de ses coûts.
- Enfin, rappelons-nous que si les mesures des usages réels permettent de quantifier le besoin en GPU, les choix architecturaux influencent aussi grandement le dimensionnement.


